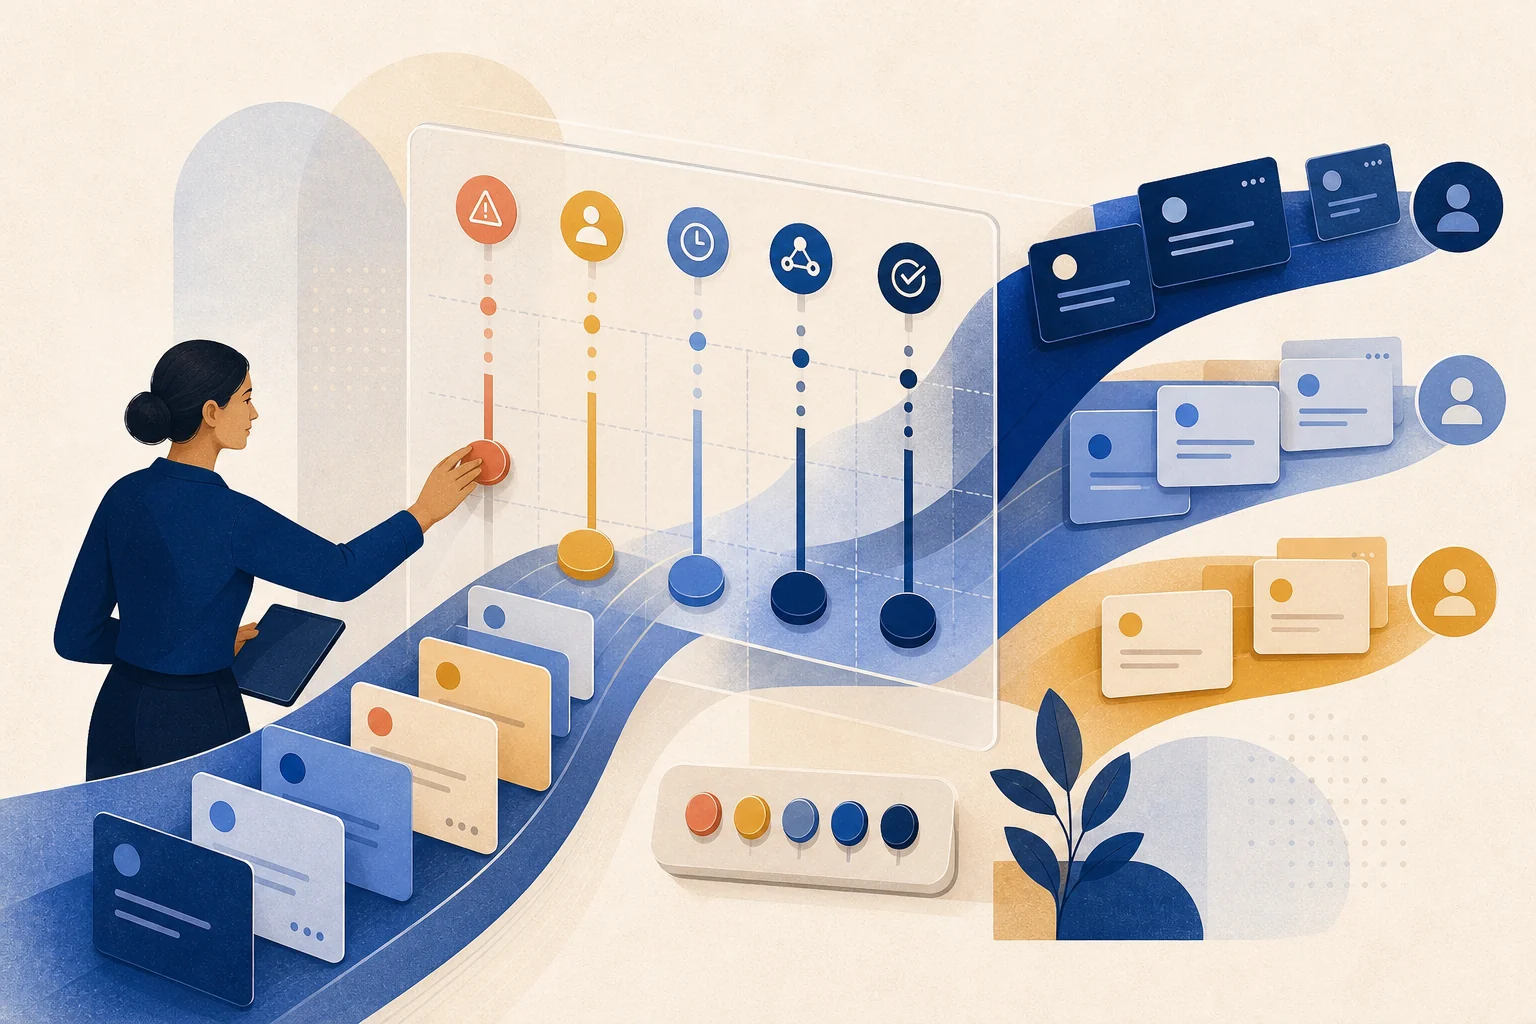
El caso más antiguo merece atención, pero no siempre va primero. La prioridad combina impacto, plazo y capacidad de actuar.
Define correctamente el backlog
Backlog es el conjunto de conversaciones que aún exige acción. Incluye no asignadas, activas, en espera del equipo y en espera del cliente, pero no mezcles esos estados. Una cola organizada muestra resumen, estado, cliente y objetivo o SLA, como describe Atlassian.
Antes de priorizar, elimina duplicados, spam y cierres incorrectos. Confirma que “esperando al cliente” tenga fecha de seguimiento y que las dependencias internas tengan responsable. Un backlog inflado por malos estados produce malas decisiones.
Matriz de prioridad
| Criterio | Pregunta |
|---|---|
| Riesgo | ¿Hay seguridad, datos, fraude, reputación o vulnerabilidad? |
| Compromiso | ¿Existe SLA, fecha prometida o evento próximo? |
| Impacto | ¿Cuántas personas, pedidos u operaciones afecta? |
| Edad | ¿Cuánto espera la siguiente acción? |
| Dependencia | ¿El equipo puede actuar o necesita un tercero? |
| Esfuerzo | ¿Una acción corta elimina incertidumbre? |
Ritual diario en cuatro bloques
- Atiende riesgo y compromisos vencidos.
- Asigna trabajo nuevo y sin dueño.
- Desbloquea dependencias y confirma responsables.
- Revisa la cola antigua para evitar abandono silencioso.
- Cada caso tiene estado, prioridad y próxima acción
- El motivo de prioridad es visible
- Lo que espera tiene fecha de seguimiento
- La reapertura vuelve con dueño
- Gestión ve entradas, salidas y cambio neto
- Los casos antiguos reciben revisión
Conecta prioridad con capacidad
Si las entradas superan resoluciones continuamente, ordenar la cola no elimina el déficit. Compara creados, resueltos, reabiertos y pendientes; Zendesk los trata por separado. Conecta backlog con primera respuesta, métricas operativas y enrutamiento. La meta es prevenir daño y hacer explícitas las decisiones.
Convierte esta guía en una rutina operativa
Empieza con un piloto pequeño y observable para aplicar “Backlog de atención: cómo priorizar más allá de la antigüedad”. Elige un equipo, un canal y un período definido. Registra la situación inicial: volumen, edad de la cola, responsables, excepciones y reclamos relacionados con el proceso. Después escribe una regla breve, indica quién decide en los casos ambiguos y documenta cómo volver al flujo anterior si algo falla. Este diseño evita una implementación amplia sin medición y permite una comparación justa entre el antes y el después.
- Objetivo operativo expresado en una frase verificable
- Responsable de ejecución y supervisor de la revisión
- Muestra de conversaciones con casos normales y excepciones
- Fecha de inicio, duración y regla de contingencia
- Métrica principal, indicador de seguridad y fuentes de eventos
- Decisión final: mantener, ajustar, ampliar o retirar
Durante el piloto, revisa conversaciones reales en lugar de confiar solo en el tablero. Confirma que estado, responsable, historial y próxima acción coincidan con la experiencia del cliente. Separa falla de proceso, limitación de herramienta, problema de integración y error de ejecución; cada causa necesita una corrección distinta. Al finalizar, publica la regla aprobada donde trabaja el equipo, retira instrucciones antiguas y programa una nueva revisión. El resultado esperado no es únicamente un número mejor, sino una operación capaz de explicar por qué cambió y de reproducir la mejora sin depender de una persona específica.