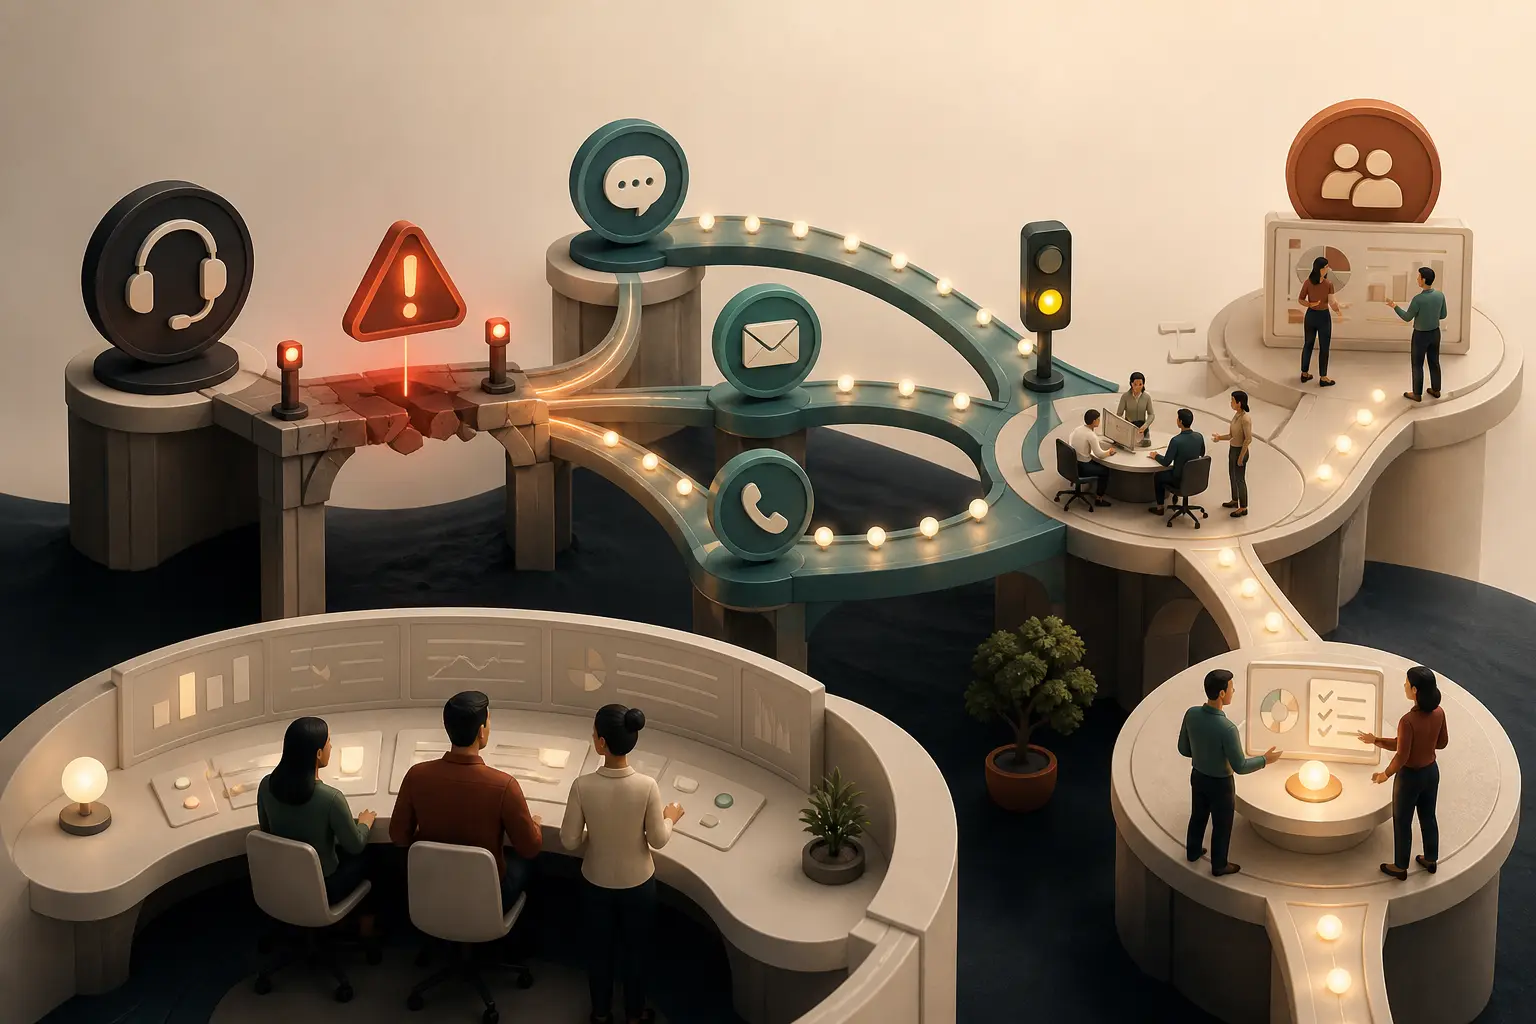
Contingência não é improvisar outro número durante a falha: é preservar responsabilidade, contexto e comunicação até a operação se recuperar.
Priorize serviços e dependências
Liste canais, provedores, autenticação, webhooks, banco de dados, CRM, conhecimento, telefonia, energia e pessoas essenciais. Para cada fluxo, estime impacto de indisponibilidade, volume acumulado, prazo tolerável e alternativas. Nem todo canal precisa do mesmo tempo de recuperação.
Faça uma análise orientada ao serviço: o cliente consegue relatar um incidente, confirmar um compromisso ou receber uma atualização crítica? A prioridade depende do efeito no negócio e na pessoa, não apenas do sistema tecnicamente fora do ar.
| Elemento | Decisão antes da falha | Evidência |
|---|---|---|
| Ativação | Qual condição inicia contingência? | Alerta e confirmação |
| Prioridade | Qual fluxo entra primeiro? | Impacto e prazo tolerável |
| Alternativa | Qual canal ou fila assume? | Teste real |
| Retorno | Quando encerrar contingência? | Reconciliação concluída |
Defina comando, comunicação e fila mínima
Nomeie responsável pelo incidente, dono técnico, líder operacional e pessoa de comunicação. Mantenha um registro de decisões, horários e estado. O canal alternativo precisa ser conhecido, acessível, protegido e capaz de conservar identificador, motivo, prioridade, responsável e próxima ação.
Comunique o que está afetado, o que continua disponível, quando haverá nova atualização e como casos urgentes serão tratados. Não declare resolução antes da validação ponta a ponta. Evite pedir ao cliente que repita tudo: recupere o contexto possível e sinalize claramente o que precisa ser confirmado.
- Comandante do incidente
- Contato técnico e operacional
- Canal alternativo testado
- Mensagem de status aprovada
- Fila manual com responsável
- Cadência de atualização
Recupere, reconcilie e aprenda
Quando o serviço volta, teste entrada, saída, anexos, identidade, atribuição e relatório. Compare eventos do provedor, sistema interno e fila alternativa. Elimine duplicatas com cuidado, preserve evidência e confirme quais compromissos ainda estão abertos.
Conduza uma revisão sem culpa: linha do tempo, detecção, impacto, decisão, comunicação, recuperação e causas contribuintes. Transforme achados em responsáveis e prazos. Atualize o plano e repita o teste; um documento não exercitado perde validade rapidamente.
Como realizar um exercício de contingência
Comece o plano de contingência em um piloto pequeno, com um canal, uma equipe e um período definido. Registre a situação inicial, a regra que será testada, o responsável por exceções e a forma de voltar ao processo anterior. Teste casos normais, ambíguos, duplicados, fora do horário e com falha de integração antes de ampliar.
Durante o piloto, compare eventos e conversas reais, não apenas médias do painel. Separe falha de processo, fonte, integração, capacidade e execução; cada causa exige uma correção diferente. Ao final, documente a decisão de manter, ajustar, ampliar ou retirar, publique a regra aprovada e marque a próxima revisão.
Mantenha um registro simples com objetivo, escopo, dono, data, evidência, exceções e resultado. A regra precisa ser encontrada no lugar em que a equipe trabalha, e a pessoa responsável deve ter autoridade para corrigir ou interromper o fluxo. Assim, o aprendizado deixa de depender de memória individual e pode ser repetido por outro turno ou equipe.
Antes de ampliar, faça uma breve revisão com atendimento, gestão e quem mantém os sistemas envolvidos. Confirme que o cliente recebe uma resposta compreensível, que a equipe enxerga o responsável e que os relatórios representam o mesmo evento observado na conversa. Se essas três visões divergem, o piloto ainda não terminou.
Continue com Centralize canais sem perder contexto, Auditoria da operação e Priorize o backlog. Use os guias em conjunto para que processo, tecnologia e gestão evoluam com a mesma definição operacional.
- Processos críticos e dependências mapeados
- Critério de ativação observável
- Responsáveis e contatos atualizados
- Canal alternativo e fila mínima testados
- Comunicação por público preparada
- Retorno exige validação ponta a ponta
- Reconciliação e revisão pós-incidente concluídas