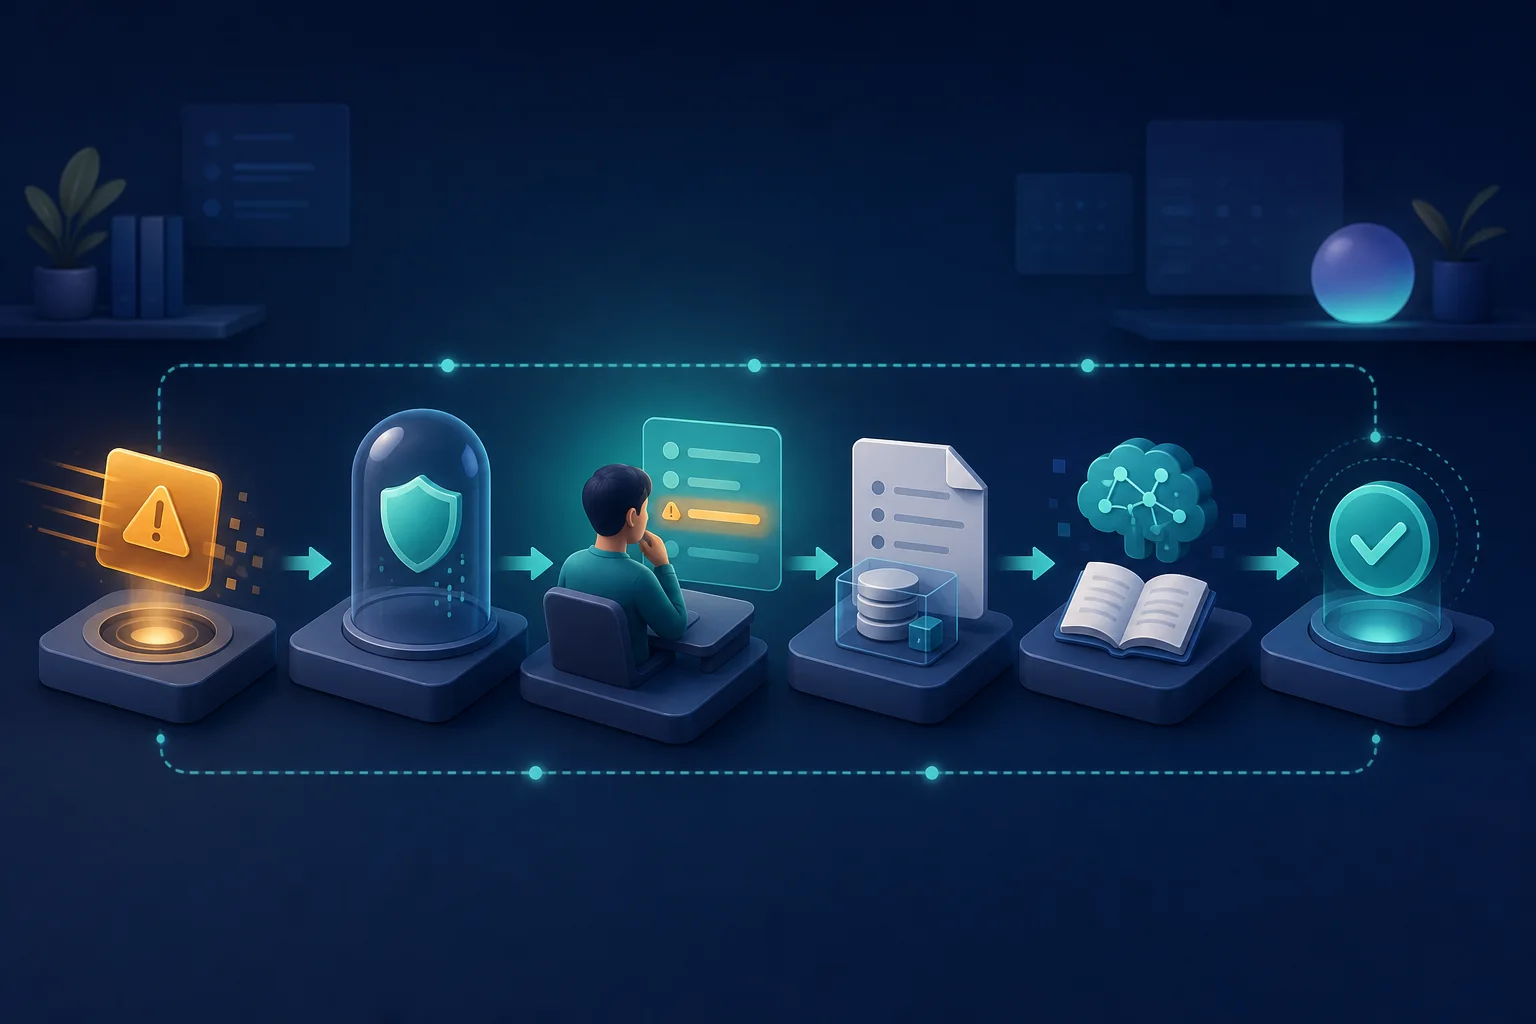
Cuando una IA da una respuesta incorrecta en atención, el primer paso no es reescribir el prompt con prisa. Limita el camino afectado según el riesgo, asigna una persona responsable a la conversación, corrige la información para el cliente, conserva el contexto que produjo la falla y solo después investiga la causa.
No toda mala respuesta es un incidente, pero toda falla necesita responsable
Una frase poco natural puede entrar en la cola normal de mejora. Una respuesta que inventa precio, plazo o política, expone datos, afirma una acción que no ocurrió, bloquea la ayuda humana o influye en una decisión sensible merece tratamiento de incidente. La diferencia está en el impacto posible, la reversibilidad y la exposición, no en lo extraña que parezca la redacción.
El NIST AI Risk Management Framework contempla monitoreo posterior al despliegue, apelación y sustitución de decisiones, respuesta a incidentes, recuperación y gestión de cambios. También pide que incidentes y errores se sigan, comuniquen y documenten. En atención, eso implica una ruta humana para el cliente y evidencia suficiente para reconstruir lo ocurrido.
Abre un registro con hora, canal, motivo de contacto, responsable y severidad provisional. No esperes una causa raíz perfecta antes de asignar un dueño. La clasificación puede cambiar; la responsabilidad no debe quedar vacía.
Usa la severidad para elegir la contención
Una sola reacción para cualquier error de IA será demasiado débil o demasiado disruptiva. Esta tabla es una síntesis operativa, no una clasificación oficial o legal; ajústala al riesgo y a las obligaciones de tu empresa.
| Nivel | Ejemplo operativo | Contención inicial |
|---|---|---|
| Bajo | Tono inadecuado u orientación incompleta, sin acción y fácil de corregir | Asumir, corregir y añadir el caso a la revisión programada |
| Moderado | Política, plazo u orientación incorrecta que puede cambiar la decisión del cliente | Desactivar la respuesta o intención afectada y buscar casos similares |
| Alto | Acción incorrecta, dato expuesto, autorización indebida o daño difícil de revertir | Pausar el flujo relevante, involucrar a responsables internos y atender a las personas afectadas |
| Crítico | Falla repetida o amplia con riesgo inmediato para personas, derechos, seguridad u operación | Detener la capacidad afectada y aplicar los planes formales de crisis, seguridad, privacidad o continuidad |
Contener no siempre significa apagar toda la IA. Puede implicar retirar una fuente, bloquear una herramienta, enviar un motivo directamente a personas o volver temporalmente a respuestas aprobadas. El alcance debe impedir la repetición sin cerrar caminos que siguen siendo seguros.
- Identifica flujo, intención, canal y versión afectados
- Confirma si la falla incluyó solo texto o también una acción
- Asigna un responsable humano y una cola de seguimiento
- Conserva evidencia antes de cambiar fuente, prompt o integración
- Busca el mismo patrón más allá de la conversación reportada
- Define quién puede autorizar la recuperación
Un flujo de respuesta en siete pasos
- Recibir: registra el aviso de un cliente, agente, monitor o auditoría sin exigir que esa persona demuestre la causa técnica.
- Asumir: incorpora a una persona identificada con el historial disponible. Confirma el próximo paso y evita transferencias en cadena.
- Contener: limita la respuesta, fuente, acción o automatización relacionada con el riesgo observado. Si el alcance no está claro, empieza de forma conservadora y ajusta con evidencia.
- Corregir: indica qué información o acción era incorrecta, presenta el estado verificado y explica qué sucederá después. No comuniques una hipótesis como corrección.
- Dimensionar: busca otras conversaciones expuestas a la misma versión, fuente, intención o herramienta. Separa exposición potencial de impacto confirmado.
- Investigar: clasifica la causa y corrige la capa adecuada. Define una prueba de salida antes de editar.
- Recuperar: prueba casos comunes, límites y el caso original, libera de forma controlada y vigila la recurrencia.
La revisión 3 de NIST SP 800-61 integra preparación, detección, respuesta y recuperación en la gestión de riesgo. Es orientación para incidentes de ciberseguridad, no un manual específico de chatbots, pero su disciplina evita confundir eliminar un síntoma con recuperar el servicio de forma segura.
Conserva evidencia y corrige la capa adecuada
Antes de cambiar algo, conserva solo la información necesaria y con acceso controlado: mensaje del cliente, respuesta generada, fuente recuperada, instrucciones aplicables, versión del modelo y del flujo, herramientas llamadas, resultados recibidos, hora y estado de la conversación. No dupliques datos personales en hojas sueltas solo para facilitar el análisis.
| Señal | Causa posible a verificar | Corrección potencial |
|---|---|---|
| La respuesta cita una regla inexistente | Conocimiento ausente, antiguo o recuperado de forma incorrecta | Corregir la base de conocimiento, propiedad, versión y criterios de búsqueda |
| La fuente correcta estaba disponible, pero la IA se excedió | Instrucción ambigua, mal ejemplo o alcance demasiado amplio | Restringir el comportamiento y añadir un ejemplo prohibido a las pruebas |
| Declaró éxito, pero la acción falló | Integración, timeout, parsing o confirmación defectuosa | Exigir confirmación del sistema antes de comunicar la conclusión |
| Continuó cuando debía detenerse | Un límite de confianza o señal de riesgo no se activó | Revisar fallback y condiciones de parada |
| Transfirió sin contexto o responsable | Contrato de handoff incompleto | Aplicar el checklist de transferencia humana |
Una conversación puede revelar varias causas. Evita usar “alucinación del modelo” como diagnóstico genérico: no indica si la empresa debe reparar conocimiento, permisos, integración, prompts, enrutamiento o supervisión.
Corrige al cliente y define criterios de recuperación
La comunicación debe ser proporcional y verdadera. Identifica la información incorrecta, proporciona una corrección verificada, aclara si una acción realmente ocurrió y ofrece un contacto responsable. Cuando el impacto active procesos formales de privacidad, seguridad, compliance o soporte especializado, sigue a los responsables y plazos aplicables de tu organización; este playbook no es asesoría legal.
No reactives porque “el prompt se ve mejor”. Antes de recuperar, confirma que:
- el caso original recibe ahora la respuesta o transferencia esperada;
- se probaron casos similares y casos límite;
- la corrección no amplió el acceso a datos ni permisos de acción;
- el responsable operativo aceptó el riesgo residual;
- existe una señal para detectar recurrencia;
- la liberación puede detenerse sin perder contexto.
Comienza con exposición controlada, revisa conversaciones reales y conserva una ruta humana. La recuperación termina cuando operaciones confirma estabilidad en el contexto real, no cuando se publica el cambio.
Convierte cada incidente en una prueba de regresión
El reporte, la salida incorrecta y la corrección esperada forman un caso de evaluación. Elimina datos innecesarios, conserva la condición que disparó la falla y registra el comportamiento que no debe repetirse. Ejecuta ese caso junto con ejemplos normales para que una corrección estrecha no rompa el resto del flujo.
La guía oficial de OpenAI sobre evaluaciones contextuales recomienda especificar el comportamiento deseado, medir en condiciones realistas y mejorar mediante análisis de errores. También recomienda medición continua después del lanzamiento. Combina las pruebas de regresión con una auditoría periódica de conversaciones de IA: los incidentes muestran fallas agudas y las muestras de rutina pueden descubrir patrones antes de que se agraven.
Cierra el registro con causa, personas o flujos afectados, decisiones, corrección, pruebas, aprobador y señales de seguimiento. Antes de volver a ampliar, regresa a un piloto controlado con modo sombra, criterios go/no-go y rollback. El objetivo no es prometer que la IA nunca se equivocará. Es asegurar que la operación pueda detectar, contener, corregir y aprender de forma trazable.