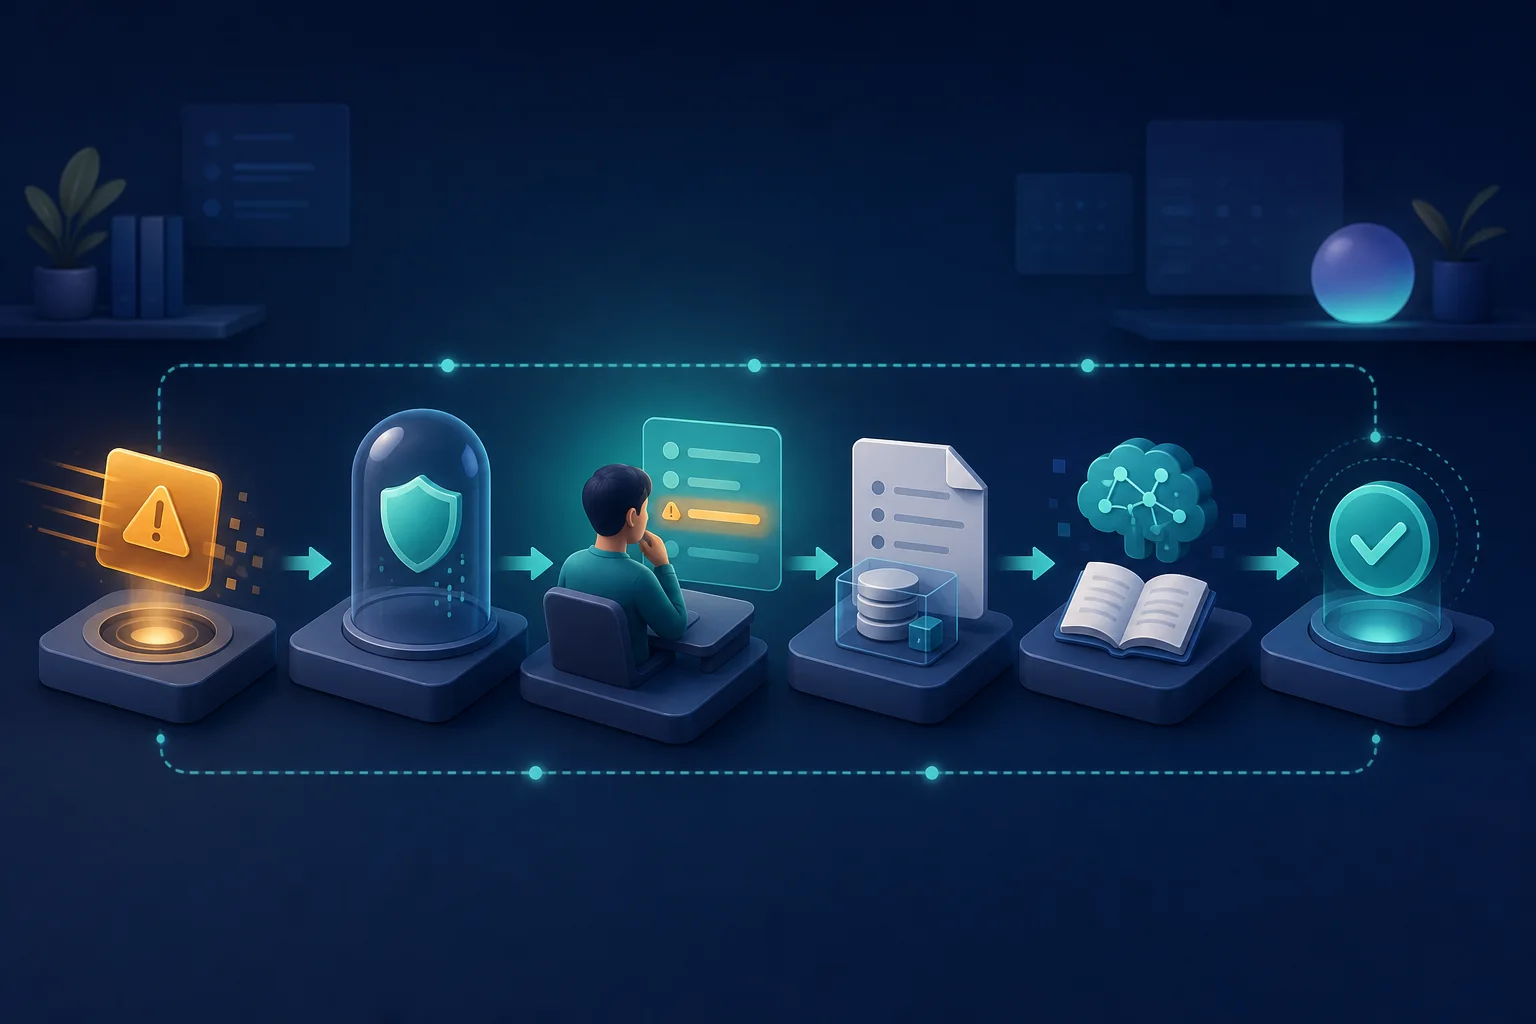
Quando uma IA dá uma resposta errada no atendimento, a primeira ação não é reescrever o prompt às pressas. A equipe deve interromper ou limitar o caminho afetado conforme o risco, colocar uma pessoa responsável na conversa, corrigir a informação para o cliente, guardar o contexto que produziu a falha e só então investigar a causa.
Nem toda resposta ruim é igual — mas toda falha precisa de dono
Um texto pouco natural pode entrar na fila normal de melhoria. Já uma resposta que inventa preço, prazo ou política, expõe dado, promete uma ação não realizada, bloqueia o acesso humano ou influencia uma decisão sensível pede tratamento de incidente. A diferença está no impacto possível, na reversibilidade e na quantidade de pessoas expostas — não no quanto a frase parece estranha.
O NIST AI Risk Management Framework inclui monitoramento pós-implantação, recurso e substituição da decisão, resposta a incidentes, recuperação e gestão de mudanças. Também orienta que incidentes e erros sejam acompanhados, comunicados e documentados. A aplicação ao atendimento é direta: o cliente precisa de uma rota humana e a empresa precisa reconstruir o que ocorreu.
Abra um registro com horário, canal, motivo de contato, responsável e severidade provisória. Não espere descobrir a causa perfeita para atribuir um dono. A classificação pode mudar; a responsabilidade não deve ficar vazia.
Classifique severidade para escolher a contenção
Não use uma única resposta para qualquer erro. A tabela é uma síntese operacional, não uma classificação oficial ou jurídica; adapte os níveis ao risco e às obrigações da sua empresa.
| Nível | Exemplo operacional | Contenção inicial |
|---|---|---|
| Baixo | Tom inadequado ou instrução incompleta, sem ação e facilmente reversível | Assumir a conversa, corrigir e incluir na revisão programada |
| Moderado | Política, prazo ou orientação incorreta que pode mudar a decisão do cliente | Desativar a resposta ou intenção afetada e procurar casos semelhantes |
| Alto | Ação errada, dado exposto, autorização indevida ou dano difícil de reverter | Suspender o fluxo relevante, acionar os responsáveis internos e tratar pessoas afetadas |
| Crítico | Falha repetida ou ampla com risco imediato para pessoas, direitos, segurança ou operação | Parar a capacidade afetada e seguir os planos formais de crise, segurança, privacidade ou continuidade |
Conter não significa desligar toda a IA por padrão. Pode ser retirar uma fonte, bloquear uma ferramenta, encaminhar um motivo diretamente para humanos ou voltar temporariamente a respostas aprovadas. O escopo deve ser amplo o bastante para impedir repetição e estreito o bastante para manter caminhos seguros funcionando.
- Identifique o fluxo, a intenção, o canal e a versão afetados
- Confirme se houve apenas texto ou também alguma ação
- Atribua um responsável humano e uma fila de acompanhamento
- Preserve evidência antes de alterar fonte, prompt ou integração
- Procure ocorrências com o mesmo padrão, não apenas a conversa denunciada
- Defina quem pode autorizar a retomada
Um fluxo de resposta em sete passos
- Receber: registre o relato do cliente, atendente, monitoramento ou auditoria sem exigir que a pessoa prove tecnicamente o erro.
- Assumir: coloque uma pessoa responsável na conversa com o histórico disponível. Confirme o próximo passo e evite transferências em cadeia.
- Conter: limite a resposta, fonte, ação ou automação relacionada ao risco observado. Se o alcance ainda é incerto, comece com uma contenção conservadora e refine com evidência.
- Corrigir: diga claramente qual informação ou ação estava errada, forneça o estado correto confirmado e explique o que acontecerá em seguida. Não apresente uma hipótese como correção.
- Dimensionar: busque outras conversas expostas pela mesma versão, fonte, intenção ou ferramenta. Separe exposição potencial de impacto confirmado.
- Investigar: classifique a causa e escolha a correção na camada certa. Defina um teste de saída antes de editar.
- Recuperar: valide casos comuns, limites e o caso original, libere para uma parcela controlada e monitore recorrência.
O NIST SP 800-61 revisão 3 integra preparação, detecção, resposta e recuperação à gestão de risco. Embora seja um guia de incidentes de cibersegurança e não um manual específico para chatbots, essa disciplina ajuda a não confundir apagar o sintoma com recuperar o serviço de forma segura.
Preserve a evidência e corrija a camada certa
Antes da mudança, guarde somente os dados necessários e com acesso controlado: mensagem do cliente, resposta gerada, fonte recuperada, instruções aplicáveis, versão do modelo e do fluxo, ferramentas chamadas, resultados retornados, horário e estado da conversa. Não replique dados pessoais em planilhas soltas para facilitar a análise.
| Sinal | Causa provável a verificar | Correção possível |
|---|---|---|
| A resposta cita uma regra inexistente | Fonte ausente, antiga ou recuperação de conteúdo inadequado | Corrigir a base de conhecimento, versão e critérios de busca |
| A IA tinha a fonte certa, mas extrapolou | Instrução ambígua, exemplo ruim ou escopo amplo demais | Restringir comportamento e adicionar exemplo proibido ao teste |
| Informou sucesso, mas a ação falhou | Integração, timeout, parsing ou confirmação inadequada | Exigir confirmação do sistema antes de comunicar conclusão |
| Continuou quando deveria parar | Limite de confiança ou sinal de risco não acionou | Rever fallback e condições de parada |
| Transferiu sem contexto ou sem dono | Contrato de handoff incompleto | Aplicar o checklist de passagem humana |
Uma conversa pode revelar mais de uma causa. Evite declarar “alucinação do modelo” como diagnóstico genérico: isso não informa se a empresa precisa corrigir conhecimento, permissão, integração, prompt, roteamento ou supervisão.
Corrija o cliente e defina critérios de retomada
A comunicação deve ser proporcional e verdadeira. Identifique a informação errada, forneça a correção verificada, esclareça se alguma ação ocorreu e ofereça um contato responsável. Se houver impacto que exija processos de privacidade, segurança, compliance ou suporte especializado, siga os responsáveis e prazos aplicáveis à sua organização; este playbook não substitui orientação jurídica.
Não reative porque “o prompt parece melhor”. Antes da retomada, confirme que:
- o caso original agora recebe a resposta ou o handoff esperado;
- casos semelhantes e casos-limite foram testados;
- a correção não ampliou acesso, ação ou dados disponíveis;
- o responsável pela operação aceitou o risco residual;
- existe um sinal para detectar recorrência;
- a liberação pode ser interrompida sem perder contexto.
Comece por um escopo controlado, acompanhe as conversas reais e preserve um caminho humano. A retomada termina quando a operação confirma estabilidade no contexto real — não quando a alteração é publicada.
Transforme cada incidente em um teste de regressão
O relato, a resposta errada e a correção esperada formam um caso de avaliação. Remova dados desnecessários, preserve a condição que provocou a falha e registre o comportamento proibido. Rode esse caso junto de exemplos normais para evitar que a correção resolva uma exceção e quebre o restante do fluxo.
A orientação oficial da OpenAI para avaliações contextuais propõe especificar o comportamento desejado, medir em condições próximas das reais e melhorar a partir da análise de erros. Ela também recomenda revisão contínua depois do lançamento. Combine o teste de regressão com a auditoria periódica de conversas: incidentes encontram falhas graves; amostras de rotina encontram padrões antes que se agravem.
Feche o registro com causa, pessoas ou fluxos afetados, decisões tomadas, correção, testes, aprovador e sinais de acompanhamento. Antes de ampliar novamente, volte a um piloto controlado com modo sombra, critérios de go/no-go e rollback. O objetivo não é prometer que a IA nunca errará. É garantir que a operação perceba, contenha, corrija e aprenda de forma rastreável.